

关于AI知识库系统,我踩过的坑比做成的单子还多。这篇不想灌鸡汤,就把实际怎么起手、哪里容易翻车,摊开讲讲。
提示词先把结构立住
玩AI知识库系统第一步不是追新模型,是把提示词结构写清楚:角色、任务、约束、输出格式。这四样齐了,输出质量立刻不一样。
我一般不写特别长的提示词,越啰嗦模型越容易跑偏。把关键约束点出来,剩下的让它发挥。
工作流比单次生成值钱
真正省时间的是把AI知识库系统串成工作流,用 n8n 或者 coze 这类工具把“输入资料、处理、输出”固化下来。单次生成再强,也强不过一个能天天跑的流水线。
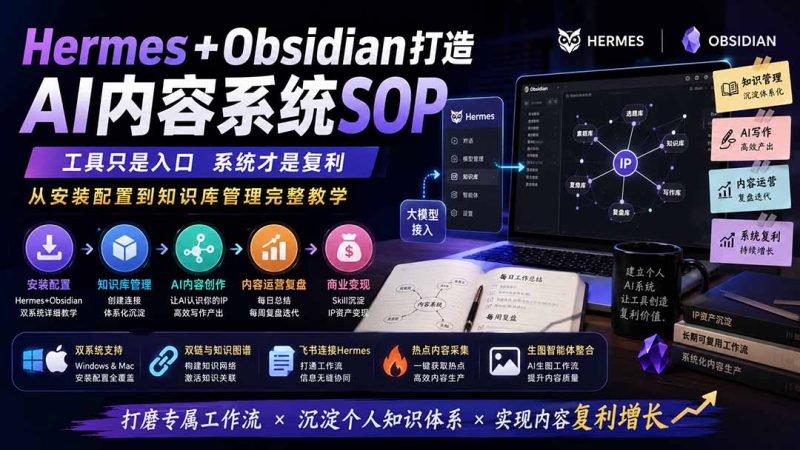
我自己的知识库先用 Obsidian 理一遍再喂给 AI,喂进去的是整理过的笔记,出来的东西才靠谱。
别迷信全自动
很多人一听“自动化”就觉得能躺赚,实际半自动更稳。关键节点留个人审,比全交给模型少出很多事故。
算力贵的时候先用小模型跑草稿,确认方向对了再上大模型精修,成本能压下来不少。
顺带说一句,我之前整理过一篇讲《Codex图片生成》的,里面有些思路和这篇能串起来;另外《Codex智能体一人公司》那篇角度不太一样,也可以对照着看。
回到开头那句,AI知识库系统不是看明白就行的事,是做出来才算数。先把AI工具这件最基础的事做踏实,比规划一个完美的方案有用。
这篇内容归类在「工作流与自动化」专题下,更多工作流与自动化相关的拆解可以看 这个合集。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END


暂无评论内容